Resumen del programa
Sobre el programa
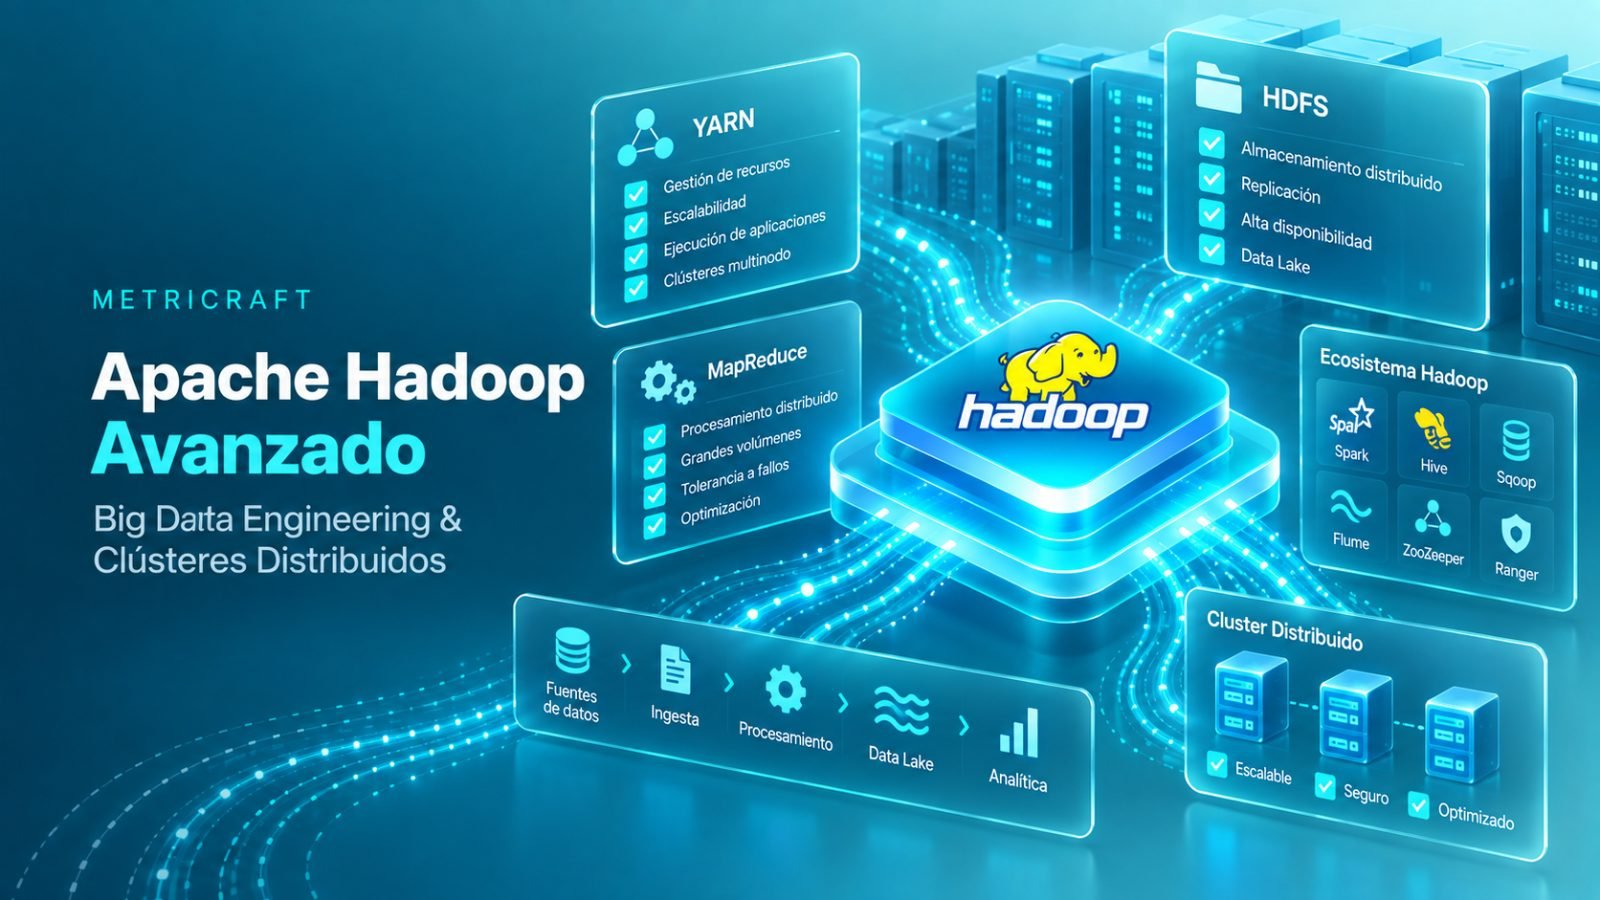
Este curso proporciona una formación integral y avanzada en Apache Hadoop y arquitecturas Big Data distribuidas. El participante comprenderá la arquitectura interna de Hadoop y aprenderá a implementar y operar clústeres mediante HDFS y YARN, integrar herramientas del ecosistema, optimizar almacenamiento y procesamiento, gestionar recursos, implementar controles de seguridad y diagnosticar problemas de infraestructura.
El enfoque combina fundamentos arquitectónicos con laboratorios orientados a situaciones reales de Data Engineering y administración de plataformas Big Data, preparando al participante para diseñar soluciones escalables y operar entornos Hadoop empresariales.
Duración
20 horas · 4 semanas
Nivel
Principiante
Categoría
Curso
Tema
Big Data
Aprendizaje práctico
Proyectos reales, laboratorios y casos de uso desde las primeras sesiones.
Docente Especialista
Ing. David Cantorín
Horarios flexibles
Rutas on demand y sesiones en vivo adaptadas a tu ritmo profesional.
Impulso profesional
Certificación, bolsa de trabajo y acompañamiento para tu siguiente rol.
Ing. David Cantorín
Data Architect
- Arquitectura Hadoop y fundamentos de sistemas distribuidos.
- Componentes del ecosistema: Hadoop Common, HDFS, YARN y MapReduce.
- Arquitectura Master/Worker y comunicación entre nodos.
- Diseño y dimensionamiento de arquitecturas Big Data empresariales.
- Preparación de servidores Linux, Java, SSH y variables de entorno.
- Instalación y configuración distribuida de Apache Hadoop.
- Configuración de HDFS, YARN y MapReduce mediante archivos XML.
- Despliegue, inicialización y validación de un clúster multinodo.
- Arquitectura HDFS: NameNode, DataNodes, bloques y replicación.
- Metadata, FsImage, EditLog, heartbeats y lectura/escritura distribuida.
- Capacidad, cuotas, ACL, snapshots y balanceo del clúster.
- Recuperación ante fallos y diagnóstico de bloques.
- Arquitectura YARN: ResourceManager, NodeManager y ApplicationMaster.
- Containers, memoria, vCores y ciclo de vida de aplicaciones.
- Schedulers, colas, prioridades y asignación de recursos.
- Monitoreo, diagnóstico y optimización de aplicaciones y nodos.
- MapReduce y ejecución de trabajos distribuidos.
- Integración de Apache Spark con Hadoop y ejecución sobre YARN.
- Apache Hive, Metastore, tablas, particiones y consultas SQL.
- Optimización con Parquet, Avro y compresión de datos.
- Arquitecturas de ingesta Batch y Streaming.
- Ingesta desde bases de datos, archivos y fuentes de eventos.
- Diseño de zonas Data Lake: Raw, Structured y Curated.
- Construcción de pipelines integrando Hadoop, Spark y Hive.
- Modelo de seguridad, usuarios, grupos, permisos y ACL.
- Autenticación y fundamentos de Kerberos.
- Autorización y políticas de acceso mediante Apache Ranger.
- Auditoría, protección de datos y buenas prácticas empresariales.
- Administración mediante CLI e interfaces web de Hadoop.
- Monitoreo de HDFS, YARN, CPU, memoria y almacenamiento.
- Diagnóstico de nodos UNHEALTHY, contenedores, discos y conectividad.
- Análisis de logs, recuperación de servicios y troubleshooting.
- Dimensionamiento de memoria, CPU, vCores y containers.
- Optimización de HDFS, YARN y parámetros de almacenamiento.
- Data locality, particionamiento, compresión y Small Files Problem.
- Optimización de Spark sobre YARN y análisis de cuellos de botella.
- HDFS High Availability y NameNode Active/Standby.
- JournalNodes, ZooKeeper y ResourceManager HA.
- Backup, Disaster Recovery y estrategias de continuidad.
- Mantenimiento, decommissioning y operación de clústeres en producción.